AI機能の応答品質を継続監視する|劣化に気づく評価の仕組み
先月リリースしたAI機能。エラーは出ていないし、現場から苦情も来ていない。順調だと思っていました。
ところがある日、ふと出力を覗いて手が止まります。なんとなく、前より雑になっている気がする。 でも、いつからなのかが分からない。比べる相手も残っていない。
これは、あなたが見張りをサボっていたから起きることではありません。AIの品質は「落ちる」のではなく「にじむ」ように変わるからです。サーバーは正常、レスポンスは200、ログにも何も残らない。それでも中身だけが少しずつずれていく。既存の監視は、そういう壊れ方を見るようにできていません。
この記事では、その「にじみ」に気づくための、小さな見張り方を一緒に組み立てます。評価基盤を作り込む話ではありません。今日、20件のお手本を用意するところから始められる範囲に絞ります。
結論:応答品質の継続監視は、次の3つで成り立ちます。①「お手本」を20〜30件だけ固定する——代表的な入力と、「こうなっていれば合格」の観点をセットにして、動かさずに置いておく。②毎朝、同じお手本を通して、前回とくらべる——大事なのは点数の高さではなく、昨日との差です。③ずれたら知らせる——気づける場所(通知やダッシュボード)に出して、週に一度は人が実物を数件読む。
判定は、機械で白黒つく項目(JSONが壊れていないか、必須項目が入っているか、禁止語がないか)から先に固めます。「良い文章か」をAIに採点させるのは、その次。採点する側の出力も揺れるので、それだけに頼らないのが安全です。
全部を今日やる必要はありません。まずは①の「お手本を20件そろえる」だけで大丈夫です。それだけで、次に「なんか変わった気がする」と思ったとき、気のせいかどうかを確かめられるようになります。
何が起きているのか——「落ちる」のではなく「にじむ」
まず、なぜここだけ勝手が違うのかを共有させてください。理由は3つあります。
1つ目は、失敗が例外として飛んでこないこと。普通の不具合なら、落ちるか、エラーを吐くか、レスポンスタイムが跳ねます。監視はそこを見ています。ところがAI機能の品質劣化は、正常に200で返ってきた、それらしい文章の中身で起きます。要約が浅くなる。丁寧語が崩れる。必要な項目がひとつ抜ける。どれもエラーにはならないので、既存の監視ダッシュボードは何も言いません。
2つ目は、変わる原因が自分たちの外にもあること。自分のコードを1行も触っていなくても、ふるまいは変わりえます。呼んでいるモデルが更新される。参照している社内資料が増えたり整理されたりする。利用者の入力の傾向そのものが季節や業務で変わる。「デプロイしていないから変わっていないはず」という前提が、AI機能では成り立たない——ここが、ふつうのシステムといちばん違うところです。同じ入力でも出力が毎回少しぶれる性質についてはAIの回答が日によって変わる|再現性のなさと付き合う型にまとめてあります。
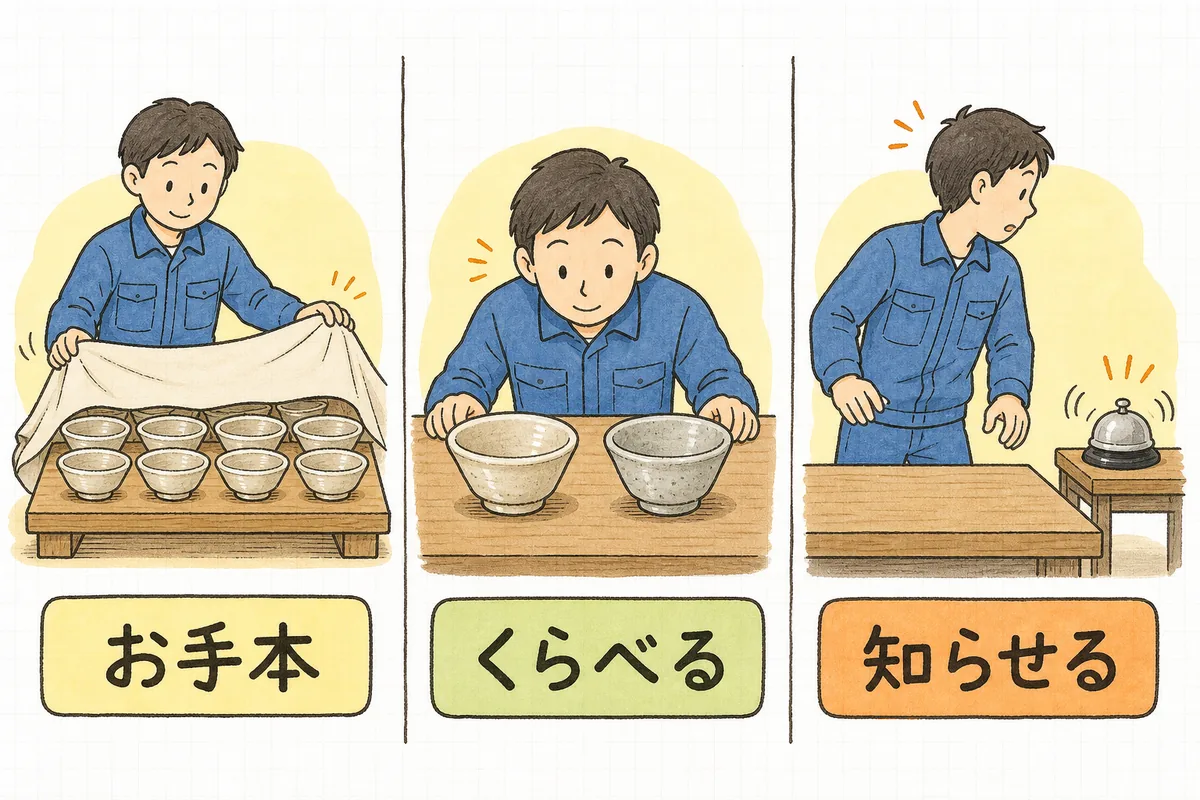
3つ目は、人が慣れてしまうこと。毎日その出力を見ている人ほど、じわじわした変化には気づけません。比べる相手が記憶しかないからです。図の左のように「動かさない見本」を先に取り分けておかないと、3か月後の自分は「前はどうだったか」を思い出せません。ここは意志の問題ではなく、仕組みの問題です。
この3つが重なると、いちばん多い気づき方が「現場から、遠慮がちに『最近ちょっと使いにくくて』と言われて初めて知る」になります。そのときには、いつからそうなったのかも、何が原因だったのかも、もう追えません。逆に言えば、見本を1つ取り分けておくだけで、この状況はかなり変わります。
具体例——こんなふうに、静かにずれていく
現場で見かけやすいのは、次のような形です。どれも「誰かがミスをした」わけではありません。
- モデルのバージョンが上がって、言い回しの傾向が変わる:全体の賢さは上がっているのに、自社のプロンプトとの相性だけが少し悪くなることがあります。以前は必ず入っていた但し書きが、なぜか出なくなる。
- JSONの形が、たまに崩れるようになる:以前は素直に返っていた構造化出力に、コードブロックの記号や前置きの一文が混ざるようになった。パース失敗率が0.1%から2%に上がっても、リトライで拾えていると誰も気づきません。復旧まで含めた設計はAIの構造化出力(JSON)を安定させる|崩れたときの復旧までを参照してください。
- プロンプトを直した副作用が、別の場面に出る:ある業務の精度を上げるために一文足したら、別の業務の回答が長くなった。直した場面しか確認していないので、しばらく分かりません。プロンプトの変更管理は本番のプロンプトを管理する|バージョン管理と壊さない運用が土台になります。
- 参照している社内資料が増えて、かえって外し始める:資料を足したのに検索の的が散り、関係の薄い文書を引くようになった。RAGの検索精度が出ないとき|見直しどころの順番にある通り、量を増やせば良くなるとは限りません。
- 入力の傾向が変わって、想定外の使われ方が増える:作ったときは短い問い合わせ文を想定していたのに、利用者がメール全文を貼るようになった。同じ品質のまま扱える範囲を超えているだけで、AIは悪くありません。
- キャッシュが効きすぎて、古い答えを返し続ける:料金や仕様が変わったのに、キャッシュに残った古い回答が出てくる。速度改善の副作用として起きやすい形です(AI応答のキャッシュでコストと速度を改善する|効かせ所の見極め)。
- フォールバックが常時発動していて、実は控えの品質で回っている:本命のモデルが混んでいて、静かに軽いモデルへ切り替わったまま数週間。切り替えは正常動作なので、ログにも「異常」とは出ません。備え方はAI出力が不安定なときのフォールバックとリトライ設計に整理しています。
- 人が黙って手直しするようになる:これがいちばん見つけにくい形です。現場は困っていますが、わざわざ報告するほどでもないので、手直しの手間を各自が飲み込んでしまう。数字にも苦情にも表れません。
並べてみると、どれも「昨日と今日をくらべる相手がいない」ことが原因で見えなくなっています。裏を返せば、比べる相手さえ用意すれば、どれも気づける種類のずれです。
影響——遅れて気づくと、直すより「説明」が難しくなる
気づくのが遅れたとき、いちばん重くなるのは修正作業そのものではありません。
- いつからずれていたかを言えない:「先週の出力と比べると」と言いたくても、先週の出力が残っていない。原因の候補も絞れず、調査が総当たりになります。
- どこまで手直しが要るか分からない:3か月ぶんの出力のうち、どれが影響を受けたのか。遡って直すのか、そのままにするのかの判断材料がないまま、報告だけを求められる状態になります。
- 現場の信頼が、静かに下がったあとで届く:品質のずれに気づいた利用者は、多くの場合まず使うのをやめます。苦情が来ないのは順調な証拠とは限らない、というのがつらいところです。
- 次の改善が通りにくくなる:一度「気づかなかった」を経験すると、次にモデルを新しくしたいと言ったときの目線が変わります。変えることそのものが怖くなるのは、いちばん避けたい状態です。
- 効果測定の数字まで疑わしくなる:品質が動いていた期間の利用実績は、比較の土台として使いにくくなります(AI機能の効果測定|導入後に見るログと指標の設計)。
ただ、ここは付け加えておきたいのですが、監視は「劣化を防ぐため」だけのものではありません。むしろ日々の値打ちは逆側にあります。お手本と比べる仕組みがあると、プロンプトを直したときに「良くなった」と言えるようになる。モデルを新しくするときに、変えてよいか自分たちで判断できるようになる。守りのために作った仕組みが、そのまま安心して前へ進むための道具になります。
明日からやること(3ステップ)
評価基盤の導入は要りません。表計算ソフトと短いスクリプトで始められます。
1. 「お手本」を20〜30件だけ固定する
最初にやるのは、図の左です。代表的な入力を集めて、動かさない形で取り分けます。
選び方は、次の配分を目安にすると偏りません。
- よくある普通の入力:10〜15件(日々の大半を占める、平凡なもの)
- 過去に失敗した入力:5件(一度おかしくなった実例。再発に気づくための、いちばん効く一群です)
- 端っこの入力:5件(極端に長い、空に近い、想定外の言語や記号が混ざる、など)
1件は次の形で書き留めます。凝った形式は不要で、表計算ソフトの1行で十分です。
| 項目 | 中身 |
|---|---|
| 入力 | 実際に投げる文面(本番のログから、そのまま) |
| 合格の観点 | 「必ず金額と期日が入っている」「120字以内」「敬語が崩れていない」など、見れば白黒つく形で3つまで |
| 落ちてはいけない線 | ここを割ったら知らせが要る、という下限 |
| 最初の答え | 今日の時点の出力(これが比較の土台になります) |
ここで大事なのは、「良い出力」を書こうとしないことです。模範解答を作り込むと手が止まります。必要なのは満点の答えではなく、今日の姿を残しておくこと。今日の出力をそのまま貼っておけば、明日以降それと見比べられます。
なお、本番ログから入力を持ってくるときは、氏名・連絡先・取引先名などを先に伏せてください。テスト用のデータを作る際の注意はAIにテストデータを作らせる|個人情報と偏りの注意、社外サービスへ渡してよい範囲は社内データをAIに渡す前の線引き|情報漏えいを防ぐ型に整理しています。
2. 毎朝、同じお手本を通して、前回とくらべる
図の中央です。同じ入力を、同じ設定で、決まった時刻に流すだけ。1日1回で構いません。
判定は、次の3層に分けて、上から順に固めます。下の層ほど手間もぶれも大きいので、無理に全部やらなくて大丈夫です。
第1層:機械で白黒つく項目(まずここだけでいい)
- JSONやCSVとして壊れずに読めるか
- 必須の項目がそろっているか
- 文字数・件数が決めた範囲に入っているか
- 禁止したい語(社外秘の用語、断定表現など)が混ざっていないか
- 応答時間とトークン数が、いつもの範囲に収まっているか
この層だけで、実は目に見える事故のかなりの部分は拾えます。しかもぶれません。書き戻し前の検証を入れているなら、その仕組みをそのまま流用できます(AI出力を業務データに書き戻す前のバリデーション設計)。
第2層:前回の出力との「変わり具合」
出力そのものを保存しておいて、前回ぶんと比べます。完全一致は求めません(毎回少しぶれるのが普通なので、一致を求めると毎日鳴りっぱなしになります)。見るのは、急に長さが変わっていないか/含まれていた語が消えていないか/構成が変わっていないか、といった粗い差です。文字列の差分を並べて目で追うだけでも、十分に役に立ちます。
第3層:AIに採点させる(できれば、の位置づけ)
「この回答は、金額と期日が入っているか。5段階で。理由も」といった形でAIに採点させる方法もあります。手軽で、文章の質にも踏み込めます。ただし採点する側の出力も揺れるので、次の3つは守ってください。
- 採点基準を短く固定し、変えたら日付を残す(基準を変えた日を境に点数は比較できなくなります)
- 点数だけでなく理由も保存する(後で人が答え合わせできるようにするため)
- 月に一度、人が10件だけ答え合わせをする(採点そのものが、いつのまにか甘くなっていないかの確認)
なお、その採点が的外れになる仕組みは、ふつうのハルシネーションと同じです(AIのハルシネーションを見抜く|もっともらしい誤りへの備え)。採点結果を、確かめずに数字として上へ報告しない。ここだけ気をつければ、便利な道具です。
費用が気になるところですが、お手本30件を1日1回通すだけなら、1日30回ぶんです。本番の利用が1日1,000回あるなら、増えるのは3%ほど(30 ÷ 1,000 = 0.03)。見積もりの立て方はAI APIの料金とレート制限を見積もる|本番前に備える型にまとめてあります。
3. ずれたら知らせる(そして、週に一度だけ人が読む)
図の右です。結果を気づける場所に出します。呼び鈴の役割を果たすものがないと、記録は取っているのに誰も見ない、という状態になりがちです。
- 知らせる条件は、最初は粗くて構いません:「第1層の合格率が前日より10ポイント以上下がったら」「1件でも読めない出力が出たら」程度から始めて、鳴りすぎるようなら緩めます。鳴りすぎる見張りは、そのうち全員が無視します——ここは、しきい値の正しさより、無視されないことを優先してください。
- 結果は1行の履歴として残す:日付/合格率/気づいたこと。表計算ソフトの追記で十分です。半年後、この1行の並びが、いちばん強い説明材料になります。
- 週に一度、実物を5〜10件、人が読む:ここは自動化しません。1件10秒でも、10件で2分弱です。数字が合格でも「読むと違和感がある」ことは起きます。その違和感が、次のお手本の1件になります。人の確認をどこに挟むかの考え方は人手の確認を挟むAIワークフロー|HITLの組み方を参考にしてください。
- 変更のたびに、まず先にお手本を通す:プロンプトを直したとき、モデルを変えるとき、参照資料を足したとき。リリース前に1回通すだけで、副作用のかなりの部分が見つかります。モデルの乗り換えを見据えた設計はAIモデルの乗り換えに備える|疎結合な組み込み設計、段階的に出す進め方は機能フラグでAI機能を安全に出す|段階リリースと切り戻しにあります。
3つとも今日やる必要はありません。ステップ1の「お手本を20件そろえる」だけでも、比べる相手ができます。 それが、いちばん大きな一歩です。
応答品質を見張るときのチェックリスト
全部に○が要るわけではありません。気になった行だけで十分です。
① お手本をそろえる
- 代表的な入力を20〜30件、本番のログから集めたか
- 過去に失敗した入力を、その中に5件ほど混ぜたか
- 極端に長い/短い/想定外の入力も少し入れたか
- 氏名・連絡先・取引先名などを伏せたか
- 1件ごとに「合格の観点」を、見れば白黒つく形で3つまで書いたか
- 今日の時点の出力を保存したか(これが比較の土台)
② くらべる
- 決まった時刻に、同じ入力・同じ設定で流す仕組みにしたか
- 第1層(形が壊れていない・必須項目がある・禁止語がない)を先に固めたか
- 出力そのものを、日付つきで保存しているか
- 応答時間とトークン数も、あわせて記録しているか
- AIに採点させるなら、基準を固定し、理由も保存しているか
- 採点の答え合わせを、人が月に一度する段取りになっているか
③ 知らせる・見る
- 結果が、誰かの目に触れる場所に出ているか
- 知らせる条件を決めたか(鳴りすぎたら緩める前提で)
- 日付・合格率・気づいたことを、1行の履歴で残しているか
- 週に一度、実物を5〜10件、人が読む時間を確保したか
- プロンプト・モデル・参照資料を変える前に、お手本を1回通す決まりにしたか
- フォールバックが発動した回数を、別に数えているか
この記事のまとめ
AI機能の品質は、ある日きれいに壊れてはくれません。200で返り続けたまま、少しずつにじみます。 だから、既存の監視の外側に、小さな見張りをひとつ置く必要があります。
やることは3つだけです。①お手本を20〜30件だけ固定する/②毎朝それを通して、前回とくらべる/③ずれたら知らせて、週に一度は人が読む。そして判定は、機械で白黒つく項目から先に固める。AIによる採点は、その次で構いません。
この仕組みは、劣化を見つけるためだけのものではありません。「良くなった」と言えるようになるための道具でもあります。比べる相手があると、次の一歩を、怖がらずに踏み出せます。
「なんとなく変わった気がする」を、ずっと胸に抱えているのはしんどいことです。でも、その違和感に気づけたということは、あなたがその機能の出力を、今もちゃんと見ているということでもあります。見ている人がいる機能は、まだ大丈夫です。お手本を20件。今日はそれだけで十分、前に進んでいます。
よければ、こちらも
- 効果を数字で示したいときはAI機能の効果測定|導入後に見るログと指標の設計
- 出力のぶれ方を知りたいときはAIの回答が日によって変わる|再現性のなさと付き合う型
- 変更で壊さない運用を作るなら本番のプロンプトを管理する|バージョン管理と壊さない運用
- 調査で困らないログにするならAIにログ出力の不足を指摘させる|障害調査で困らない設計