文字コードとは?文字化けが起きる仕組みを開発の現場目線でやさしく解説
「こちらでは読めるんですけどね」の正体
出力したファイルを送ったら、「文字化けしていて読めません」と返ってきた。慌てて自分の環境で開き直すと、何ともない。ちゃんと日本語で表示されている。相手にもう一度開いてもらっても、やっぱり読めない。
この気まずいやり取りの中心にいるのが、文字コードです。
文字コードとは?ひとことで言うと
文字コードとは、ざっくり言うと、「あ」や「A」といった文字を、コンピュータが扱う数値に対応づけるための決まりのことです。文字エンコーディング、あるいは単にエンコーディングとも呼ばれます。
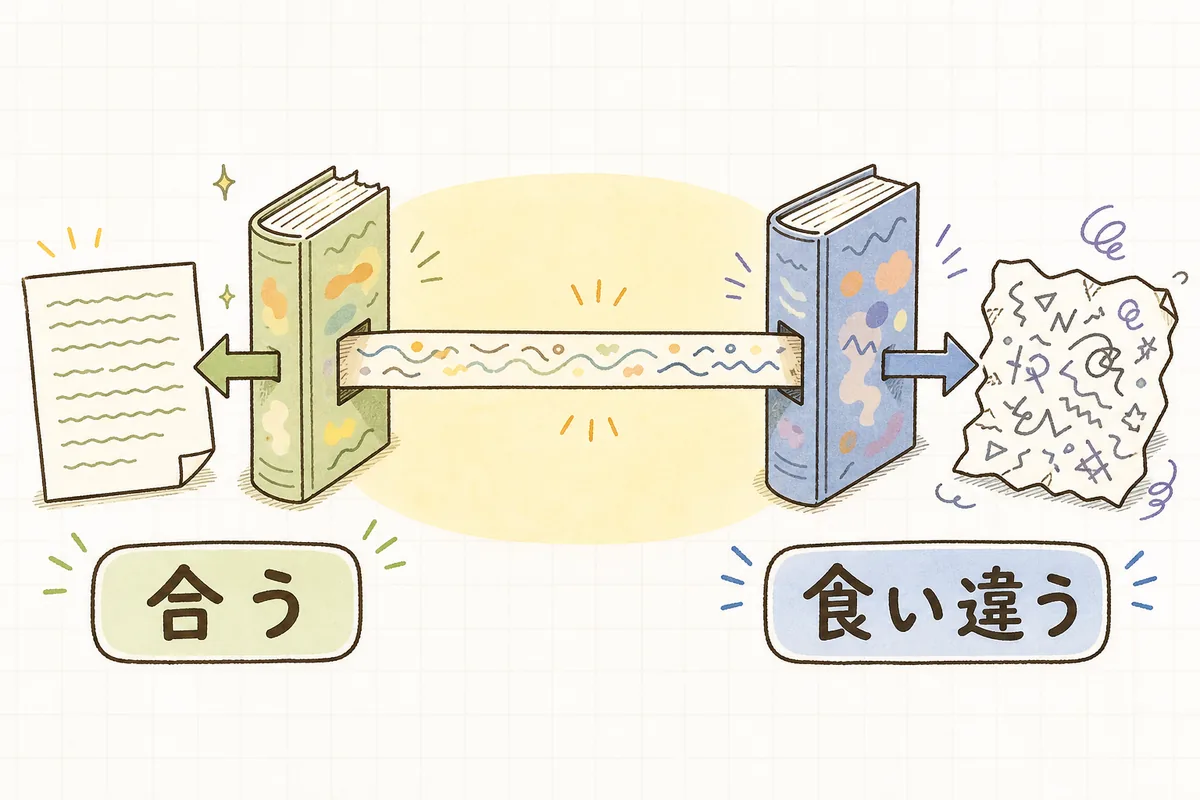
コンピュータの中には、文字そのものは入っていません。入っているのは数値の並びだけです。だから「この数値の並びは、どの決まりで文字に戻すのか」を合わせないと、正しく読めません。
同じ数値の並びでも、別の決まりで読むと別の文字になる。文字化けとは、書いたときの決まりと、読むときの決まりが食い違っている状態です。
開発現場ではどこで使う?
実際の開発では、こんな場面で出てきます。
- CSVやテキストファイルを書き出す・読み込む
- 別のシステムとファイルやAPIでデータをやり取りする
- データベースに日本語を保存する
- ログや設定ファイルを開く
- 古いシステムから移行したデータを扱う
つまり、データが自分のプログラムの外に出入りするところ全部です。中で処理している間は問題になりません。境界でだけ起きます。
よく出てくる名前を3つだけ
現場で見かけるものは、実質この3つを押さえれば足ります。
- UTF-8:いま最も広く使われている決まり。世界中の文字を扱えます。新しく作るものは、迷ったらこれです。
- Shift_JIS(CP932):日本語向けに古くから使われてきた決まり。いまも業務システムや官公庁の様式で指定されることがあります。扱える文字の範囲が狭く、「髙」のような異体字や一部の記号が表現できません。
- BOM(バイトオーダーマーク):文字コードそのものではなく、ファイルの先頭に付ける「これはUTF-8ですよ」という短い目印のこと。表計算ソフトはこの目印があるとUTF-8だと判断しやすくなります。
なぜ大事なのか
文字コードのずれが厄介なのは、壊れていることが、書いた側からは見えないからです。
プログラムは何のエラーも出しません。ファイルは正しく作られ、正しいサイズで保存されます。あなたの環境で開けば、ちゃんと日本語です。問題が姿を現すのは、環境の違う相手が開いた瞬間だけ。だから発見が遅れ、しかも「こちらでは再現しない」という一番調べにくい形で報告が来ます。
もうひとつ、あとから直しにくいという性質もあります。誤った決まりで読み込んで保存し直したデータは、元の文字が失われていることがあります。そうなると、正しい文字コードを指定しても戻りません。
具体例で見る
たとえば、会員名簿をCSVで書き出す処理を作ったとします。コードには文字コードの指定を書いていません。
開発機での動作は完璧でした。日本語の氏名も、住所も、正しく表示されます。開発機の既定がUTF-8だったからです。
ところが本番のサーバーは、既定の設定が違いました。同じコードが、違う決まりでファイルを書き出します。受け取った担当者が開くと、氏名の列が読めない記号の羅列になっている——コードは1文字も違わないのに、動く場所によって結果が変わったわけです。
これが、文字コードを「指定しないこと」の怖さです。指定しなければ、環境が勝手に決めます。そして環境は、開発機と本番で同じとは限りません。
つまり現場では?
現場でやることは、シンプルです。外とやり取りするところでは、文字コードを必ず自分で書く。
読み込むときも、書き出すときも、「環境の既定」に任せない。コードの中に明示しておけば、どこで動いても同じ結果になります。
そして、どの決まりにするかは、受け取る相手から決めます。技術的にどれが優れているかではなく、相手が何で開くのか。日本の業務現場で表計算ソフトで開かれるならBOM付きUTF-8、別のプログラムが読むならBOMなしUTF-8、というように、用途で使い分けます。
知らないとどう困る?
AIにファイル入出力のコードを書かせると、文字コードの指定が省かれた素直なコードが返ってくることがよくあります。前提を渡していないので、指定のしようがないからです。
そのまま受け取ると、テストは通り、レビューも通り、本番で初めて壊れます。しかも壊れ方が環境依存なので、「特定のお客さんだけ文字化けする」といった、原因にたどり着きにくい形で出ます。
逆に言えば、レビューで encoding の指定があるかを見るだけで、この種の事故はかなり減らせます。見るのは一瞬です。
よくある勘違い
- 「UTF-8にしておけば全部大丈夫」ではありません。受け取る側がUTF-8を想定していなければ、やはり化けます。相手に合わせるのが原則です。
- 「BOMを付ければ安全」でもありません。BOMは目印であってデータではないので、知らないプログラムが読むと1列目の先頭に見えないゴミが付いたように扱われます。「なぜか1列目だけ列名が一致しない」の典型的な原因です。
- 文字化けと、表計算ソフトの自動変換は別物です。先頭のゼロが消える、長い数字が丸められる、といった現象は文字コードとは関係ありません。ファイルは正しく、開いたあとの解釈が変わっているだけです。
- 「日本語だけの問題」でもありません。半角カナ、丸数字、環境依存文字、絵文字なども、決まりによって扱えたり扱えなかったりします。
明日やるならこれ
直近で書いた(あるいはAIに書かせた)ファイル入出力の処理を、1つだけ開いてみましょう。ファイルを開く行に、文字コードの指定があるか。 それだけ見れば十分です。
指定がなければ、そのファイルを誰が受け取るのかを思い浮かべて、1つ決めて書き足す。1行の追加で、環境が変わっても結果が変わらないコードになります。
ひとことで言うと
文字コードとは、文字と数値を対応づける決まりのこと。文字化けは、書いたときの決まりと読むときの決まりの食い違いです。外とやり取りするところでは、環境任せにせず必ず自分で指定しておく——それだけで、あの気まずい連絡はぐっと減ります。
関連用語
 正常系・異常系とは?テストで「うまくいく場合」と「失敗する場合」をやさしく解説
 単体テスト(ユニットテスト)とは?部品ひとつの動きを確かめることをやさしく解説
 差分(diff)とは?AIが変えた箇所だけを確認する考え方をやさしく解説
 プロンプトとは?AIへの指示文をやさしく解説