AIに書かせたCSV出力|文字化けと桁ズレを防ぐ確認手順
「CSV出力の処理、書いておいて」——AIにそう頼んで、出てきたコードを読んで、テストデータで動かして、問題なし。そこまでは、いつもどおりでした。
問題が出るのは、たいてい何日か経ってからです。お客さんから「ファイルが文字化けしていて読めません」と連絡が来る。あるいは、経理の担当者から「電話番号の頭の0が消えているんですけど」と言われる。慌てて自分の環境で開き直すと、何ともない。自分の画面では、ちゃんと正しく見えている。
この「手元では合っているのに、相手の画面では壊れている」は、CSVで最も起きやすい事故です。そして、あなたの確認が甘かったからではありません。CSVは見た目がただのテキストなので、壊れていても壊れているように見えない。そのうえ、AIには「このファイルを誰が、何で開くのか」という肝心の前提が渡っていない。だから、どこの国でも通じる無難なコードが返ってくるだけなのです。
結論:AIに書かせたCSV・帳票の出力は、次の順に見ると事故がぐっと減ります。①「誰が何で開くか」から文字コードを決める(相手が日本の業務現場でExcelなら、BOM付きUTF-8が無難)。②区切り・改行・引用符のエスケープが仕様どおりか確かめる——カンマや改行を含むデータで一度壊してみるのが早いです。③Excelで化けやすい3つの値(先頭ゼロ・けた落ち・日付化)を守る。④先頭が=+-@の値を無害化する(開いた瞬間に数式として動くことがあります)。⑤最後に、実データに近い1件を実際に相手と同じ手順で開いてみる。コードを読むより、1回開くほうが確実です。
一度に全部やらなくて大丈夫です。今日は、直近でAIに書かせたCSV出力を1つ開いて、encoding の指定があるかを見るだけでも十分です。そこが空欄なら、それだけで一番大きな穴がひとつ塞がります。
なぜAIのCSV出力は「手元では通る」のか
まず、いま何が起きているのかを整理させてください。
AIがCSVの書き出しを書くとき、渡されていない情報が3つあります。このファイルを誰が開くのか。何のアプリで開くのか。中にどんな値が入るのか。 この3つがないと、いちばん短くて素直なコードが返ってきます。文字コードの指定がなく、値はそのまま並べる、シンプルなコード。これは間違いではありません。前提のない場所では、それが正解だからです。
そして、そのコードはあなたの環境では正しく動きます。開発機の既定の文字コードはたいていUTF-8で、テストデータには日本語の氏名や長い数字がそこまで入っていない。だから通ってしまう。
ずれるのは、その先です。
- 相手の環境が違う:日本の業務現場では、CSVは高い確率で表計算ソフトで開かれます。読み手のソフトやバージョンによっては、文字コードの判定が期待どおりにならず、日本語が読めない列になります。
- 実データが違う:テストの「山田太郎」は通っても、本番の住所に入っている「A社, B事業部」のカンマや、備考欄の改行、
髙のような環境依存の文字がファイルを崩します。 - 書き出しは正しいのに、開くときに変わる:これがいちばん厄介です。ファイルの中身は
"0120..."と正しく入っているのに、表計算ソフトが「これは数字だな」と解釈して先頭のゼロを落とす。ファイルを疑って何時間も探しても、原因はファイルの外にあります。
どれも、AIの能力の問題ではありません。人間の開発者に「CSV出力を書いておいて」とだけ頼んでも、まったく同じものが上がってきます。前提が渡っていないだけ。だから、直す場所は出力コードではなく、頼み方と確認の順番です。
① 文字コードは「誰が開くか」から決める
最初に決めるのは、技術的な好みではなく受け取る人の環境です。
- 相手が日本の業務現場で、表計算ソフトで開く:BOM付きUTF-8が無難です。BOM(バイトオーダーマーク)は、ファイルの先頭に付ける「これはUTF-8ですよ」という短い目印のこと。これがあると、表計算ソフトがUTF-8だと判断しやすくなります。Pythonなら
encoding="utf-8-sig"がこれにあたります。 - 相手が別のシステムで、プログラムが読み込む:BOMなしUTF-8にします。BOMは目印であってデータではないので、読み込む側が知らないと、1列目の見出しの先頭に見えないゴミが付いたように扱われます。「なぜか1列目だけ列名が一致しない」の典型的な原因がこれです。
- 相手のシステムが古く、Shift_JIS(CP932)を指定してきた:指定に従います。ただし、Shift_JISで表現できない文字があることは先に共有しておきましょう。「髙」のような異体字や、一部の記号・絵文字が該当します。変換時にエラーで止めるのか、代替文字に置き換えるのかを、勝手に決めずに相談して決めておくと後で揉めません。
大事なのは、どれが正解かではなく、決めてから書かせることです。決めずに書かせると、AIは環境依存の既定値のまま出します。そして環境依存の既定値は、本番のサーバーとあなたのPCで違うことがあります。
もうひとつ、地味ですが効くのが改行の扱いです。Pythonの標準ライブラリでCSVを書くときは、ファイルを開く側で newline="" を指定します。これがないと、環境によっては改行が二重になり、1行おきに空行が入ったファイルができあがります。AIはこの指定を落とすことがあるので、レビューで見る価値があります。
② 区切り・改行・引用符のエスケープを確かめる
CSVは「カンマで区切るだけ」に見えて、実は取り決めがあります。よく使われるRFC 4180という取り決めでは、次のようになっています。
- 値の中にカンマ・改行・ダブルクォートが含まれるときは、値全体をダブルクォートで囲む。
- 値の中のダブルクォートは、2つ重ねて(
"")表す。
言語標準のCSVライブラリを使っていれば、ここは自動で面倒を見てくれます。危ないのは、AIが「その場で文字列を組み立てる」書き方を出したときです。",".join(values) のような一行は、読みやすくて速くて、そして値にカンマが入った瞬間に列がずれます。ずれた行だけが壊れるので、100件中3件だけおかしい、という気づきにくい形で出ます。
確かめ方は簡単です。わざと壊れるデータを1件混ぜて、書き出して、読み戻す。
- 住所に
東京都〇〇区1-2-3, △△ビルのようにカンマを入れる - 備考欄に改行を入れる
- 会社名に
"株式会社テスト"のようにダブルクォートを入れる - 氏名にタブ文字を入れる
この4件を通して、書き出したファイルを同じプログラムで読み戻したとき、元と同じ値に戻れば合格です。この「書いて、読み戻して、一致を見る」確認は、生成コードをそのまま使わない|最低限の動作確認の型で書いた考え方と同じで、CSVでは特によく効きます。目で見ても壊れが分からないぶん、機械に往復させるのが確実です。
なお、こういう「意地悪なデータ」を考えること自体を、AIに手伝ってもらうこともできます(AIにテストの境界値・異常系を洗わせる)。ただし出てきた候補は、自分の業務データに実際にありそうかで選び直してください。現場にない値を100件試すより、ありそうな4件のほうが役に立ちます。
③ 表計算ソフトで化ける3つの値を守る
ここからは、ファイルは正しいのに、開くと違って見える話です。切り分けの意味でも、この3つは覚えておく価値があります。
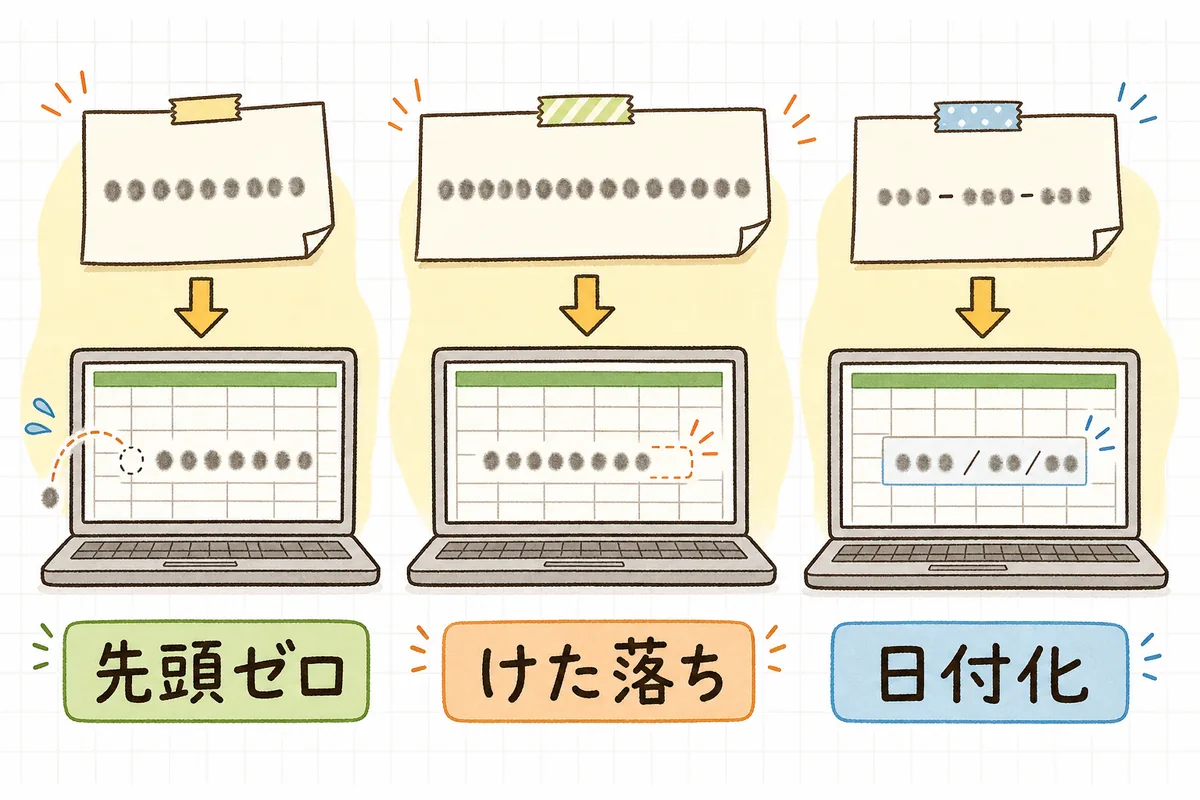
先頭ゼロ:0120-... の電話番号、007 のような枝番、先頭が0の郵便番号や社員番号。表計算ソフトはこれを数値と見なして、先頭のゼロを落とします。ファイルの中には残っているのに、画面からは消える。
けた落ち:桁数の多い数字は、表示が指数表記(1.23457E+11 のような形)に変わったり、有効桁の上限を超えた部分が0に置き換わったりします。会員番号や取引IDのような計算しない数字ほど、桁が長くて危ない。
日付化:1-2 や 2-10 のような、ハイフンでつないだ短い記号。品番や部屋番号として入れたつもりが、開いた瞬間に日付として解釈されます。一度日付になると、元の文字列には戻せません。
守り方は、どちらの都合を優先するかで変わります。
- 人が表計算ソフトで見るためのファイルなら、該当する値を
="0120..."のように書く手があります。表計算ソフト側で「これは文字列」と扱ってくれます。ただしこれは表計算ソフト向けの細工なので、同じファイルを他のプログラムが読むと="ごと値として入ってきます。両方の用途に使うファイルには向きません。 - プログラムが読むためのファイルなら、余計な細工はせず素直に出します。そのうえで、人が開くときは「開く」ではなく「データとして取り込む」手順を案内するほうが安全です。取り込みの画面で、その列を「文字列」として指定できます。
- どちらにしても、この列は文字列として扱ってほしい、と仕様に一行書いておくのがいちばん効きます。受け渡しの取り決めは、コードでは表現しきれません。
近ごろの表計算ソフトには、こうした自動変換を抑える設定が入ってきていますが、相手のバージョンや設定は選べません。「向こうで設定してもらえば大丈夫」に寄りかからず、こちら側で出し方を決めておくほうが、結局は手間が少なくて済みます。
④ 先頭が = + - @ の値を無害化する
もうひとつ、見落とされやすいのに影響が大きいものがあります。セルの先頭が = + - @ などで始まっていると、表計算ソフトがそれを数式として解釈することがある、という性質です。
たとえば、ユーザーが入力したお問い合わせの本文や、自由記述の備考欄。そこに入った文字列がそのままCSVに出て、担当者がファイルを開いた瞬間に数式として動く。単に表示が壊れるだけのこともあれば、外部への参照を含む式が仕込まれていることもあります。利用者の入力した文字列が、そのまま別のソフトの命令として実行されるという点で、これは表示の問題ではなくセキュリティの問題です(一般に「CSVインジェクション」「数式インジェクション」と呼ばれます)。
AIにCSV出力を書かせて、この対策が最初から入っていることは、まずありません。頼まないと入らない種類の処理だからです。
対策は難しくありません。
- 利用者が自由に入力できる列を洗い出す(氏名・備考・お問い合わせ本文・商品名など)。
- その列の値が
=+-@やタブ・復帰文字で始まっていたら、先頭にシングルクォート(')を足す、または前後をダブルクォートで囲んだうえで先頭に無害な1文字を付ける。どちらにするかは、受け取り側と相談して決めます。 - 社内システムだから大丈夫、とは考えない。ファイルは転送されるものです。作った人と開く人が同じとは限りません。
数値として計算に使う列まで一律に加工すると、今度は受け取り側が困ります。対象は「人が自由に入力した文字列の列」だけ、と線を引くのが実務的です。この手の「AIは頼まれないと書かない安全側の処理」については、AI生成コードのセキュリティ確認|見落としやすい穴にも近い観点をまとめています。
⑤ 実データに近い1件を、相手と同じ手順で開く
ここまで整理しても、最後にひとつだけ、代わりのきかない確認があります。相手と同じやり方で、一度開いてみることです。
- 本番に近いデータを1件用意する(漢字の氏名、カンマ入りの住所、先頭ゼロの電話番号、長い会員番号、備考欄の改行が入っているもの)。
- 相手がやる操作をそのままなぞる。ダブルクリックで開くならダブルクリックで。取り込み機能を使う運用ならその手順で。自分の慣れたやり方に置き換えないことが肝心です。
- 見るのは4つだけ。日本語が読めるか。列がずれていないか。ゼロや桁が消えていないか。日付になっている列はないか。
30秒で終わります。そして、この30秒で見つかる不具合は、リリース後に見つかると半日仕事になります。
もし社内に受け取り側の環境がないなら、「開いた画面のスクリーンショットを1枚だけ送ってください」と先に頼んでおくのも手です。相手にとっては数十秒の作業で、こちらは確信を持ってリリースできます。頼みにくく感じるかもしれませんが、後から直すやり取りのほうが、お互いずっと大変です。
AIに渡す前提の文例
書かせる前に、この程度を添えるだけで結果が変わります。コピーして、<> の中だけ埋めてください。
前提:
- 出力するのはCSV。受け取るのは<日本の業務担当者/別システム>で、<表計算ソフトで開く/プログラムが読み込む>。
- 文字コードは<BOM付きUTF-8 / BOMなしUTF-8 / Shift_JIS>。改行は CRLF。
- 標準のCSVライブラリを使い、自前で文字列連結しない。
- 値にカンマ・改行・ダブルクォートが含まれても壊れないこと(引用符で囲み、内側の引用符は2つ重ねる)。
- 次の列は文字列として扱う:<電話番号・会員番号・品番>。数値に変換しない。
- 利用者が自由入力する列(<備考・お問い合わせ本文>)は、先頭が = + - @ の場合に数式として解釈されないよう無害化する。
- 大量件数でもメモリに全件溜めない書き方にする。
- 使うのは <言語・バージョン> と <標準ライブラリ>。他のライブラリは追加しない。最後の2行を忘れないでください。件数の前提がないと、AIは全件をメモリに読み込んでから書き出す素直なコードを出します。開発中の100件では快適に動き、本番の50万件で落ちます。前提の渡し方そのものはAIにコードを書かせる前に渡す前提と制約|伝え方の型に詳しくまとめました。
明日やること(小さく3つ)
全部を一度にやろうとすると重いので、まずこの3つから。
- 直近のCSV出力コードを1つ開いて、文字コードの指定を見る。指定がなければ、受け取る相手を思い浮かべて1つ決める。ここが一番大きな穴です。
- カンマと改行を含むデータを1件混ぜて、書き出して読み戻す。元の値に戻れば、エスケープは効いています。
- 自由入力の列が出力に含まれていないか確認する。含まれていたら、先頭が
=+-@の場合の扱いを決める。
チェックリスト(コピーして使えます)
AIに書かせたCSV・帳票の出力をレビューするときの確認項目です。一度に全部でなく、今日は使える所だけで十分です。
文字コードと改行:
- 受け取る相手と、開くソフトを把握しているか
- 文字コードをコード上で明示しているか(環境の既定に任せていないか)
- 表計算ソフトで開くならBOM付き、プログラムが読むならBOMなしを選べているか
- Shift_JIS指定の場合、変換できない文字の扱い(エラーか置換か)を決めているか
- 改行が二重になっていないか(空行が1行おきに入っていないか)
エスケープと構造:
- 標準のCSVライブラリを使っているか(自前の文字列連結になっていないか)
- 値にカンマが入っても列がずれないか
- 値に改行が入っても行が割れないか
- 値にダブルクォートが入っても壊れないか
- 書き出して読み戻したとき、元の値に一致するか
- 見出し行の列数と、データ行の列数が一致しているか
開いたときに変わる値:
- 先頭ゼロの列(電話番号・郵便番号・枝番)が消えていないか
- 桁の多い数字(会員番号・取引ID)が丸められたり指数表記になっていないか
- ハイフン入りの短い記号(品番・部屋番号)が日付になっていないか
- 文字列として扱ってほしい列を、仕様書に明記しているか
安全性:
- 利用者が自由入力できる列を洗い出しているか
- 先頭が
=+-@の値を無害化しているか - 個人情報を含むファイルの保存先・保持期間・受け渡し方法を決めているか
最後の確認:
- 本番に近いデータ1件で、相手と同じ手順で開いてみたか
- 件数が増えてもメモリに全件溜めない書き方になっているか
- 出力にかかる時間を、本番相当の件数で一度測ったか
最後に
CSVの不具合は、報告のされ方がいつも少しつらいものです。「文字化けしています」「数字が違います」——こちらの手元では再現しないので、疑われている気持ちになりながら原因を探すことになる。しかも直してみれば、原因は1行の指定漏れだったりします。
でも、それは腕の問題ではありません。CSVという形式が、壊れていることを見せてくれないというだけのことです。だから、見えないものを見えるようにする手順を、一度だけ用意しておけばいい。文字コードを決める。往復させて確かめる。相手と同じ手順で1回開く。この3つが習慣になると、あの気まずい連絡はぐっと減ります。
今日は、直近のCSV出力を1つ開いて、文字コードの指定があるかどうかだけ見てみてください。そこに一行足せた時点で、次のリリースはもう少し静かなものになります。焦らず、一つずつでいきましょう。
よければ、こちらも
- 生成コードの最低限の確かめ方は 生成コードをそのまま使わない|最低限の動作確認の型
- 前提の渡し方は AIにコードを書かせる前に渡す前提と制約|伝え方の型
- 同じ「環境で変わる」系の事故は AIに書かせた日付処理|タイムゾーンのずれを防ぐ確認手順
- 出力を保存・送信する前の検証は AIの出力を保存・送信する前に検証する|壊れたデータを通さない型